오프닝: 추천의 시대, 이제는 '선택'의 시대#
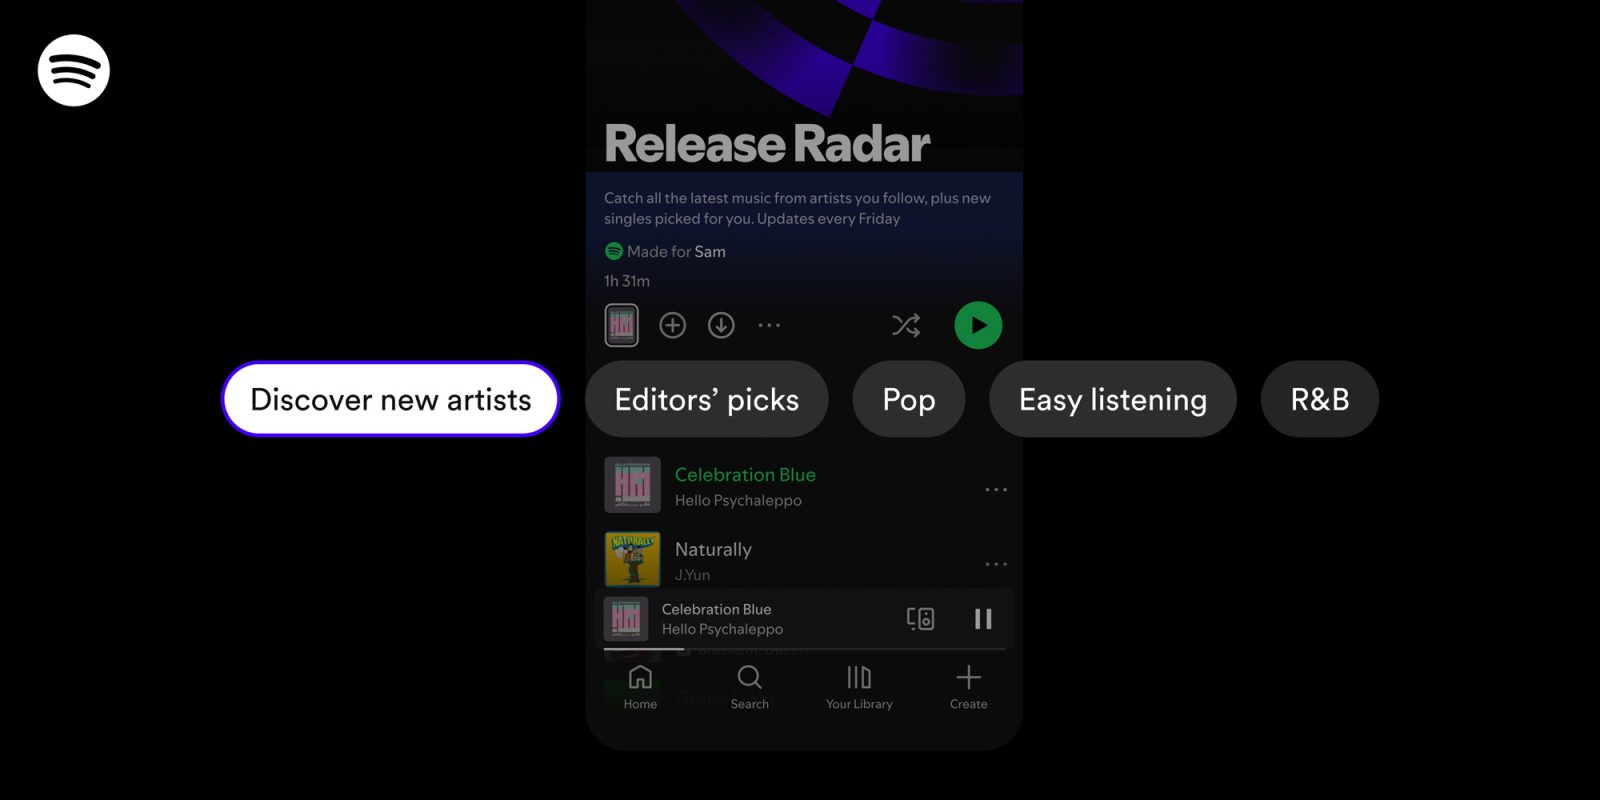
코드마스터입니다. 핵심부터 짚겠습니다. Spotify가 매주 금요일 사용자에게 신곡을 배달하는 'Release Radar'에 새로운 리스닝 필터(Listening Filters) 기능을 도입했습니다. 이는 단순히 새로운 버튼 하나가 추가된 수준이 아닙니다. 사용자가 알고리즘의 결과물을 수동적으로 수용하던 단계에서 벗어나, 추천 엔진의 출력값(Output)을 직접 제어할 수 있는 '인터랙티브 큐레이션' 단계로 진입했음을 의미합니다.
한국은 전 세계에서 가장 고도화된 스트리밍 시장 중 하나입니다. K-Pop 팬덤의 데이터 소비 패턴은 매우 정교하며, 특정 장르나 아티스트에 대한 충성도가 극도로 높습니다. 이러한 한국 사용자들에게 이번 업데이트는 알고리즘이 주는 '우연한 발견'의 즐거움과, 자신이 원하는 음악만을 골라 듣고자 하는 '정밀한 제어' 사이의 균형을 맞출 수 있는 중요한 전환점이 될 것입니다.
핵심 내용: 알고리즘 아키텍처에 '제약 조건'을 추가하다#
기술적인 관점에서 이번 업데이트를 살펴보면, Spotify의 추천 엔진 아키텍처에 '사용자 정의 제약 조건(User-defined Constraints)'이 레이어로 추가된 것으로 분석됩니다. 기존의 Release Radar는 사용자의 과거 청취 이력, 좋아요(Like)를 누른 곡, 스킵(Skip)한 곡 등의 '암시적 피드으로(Implicit Feedback)'를 기반으로 한 딥러닝 모델의 추론 결과였습니다. 즉, 시스템이 계산한 확률값이 가장 높은 곡들을 일방적으로 Push하는 방식이었죠.
이번에 도입된 필터 기능은 일종의 '필터링 레이어' 역할을 합니다. 이를 개발자들에게 익숙한 비유로 설명하자면, CI/CD 파이프라인에서 빌드된 아티팩트(Artifact)를 검증할 때 특정 유닛 테스트(Unit Test)를 통과한 결과물만을 선별하여 배포하는 과정과 유사합니다. 사용자가 '장르', '템포', '분위기' 등의 필터를 설정하면, 추천 엔진이 생성한 거대한 후보군(Candidate Generation) 중에서 해당 조건에 부합하지 않는 데이터 노드들을 트리거링하여 결과값에서 제외시키는 방식입니다.
이 과정에서 데이터 파이프라인의 복잡도는 증가할 수밖에 없습니다. 사용자의 실시간 필터 변경 요청을 반영하여 추천 리스트를 재계산(Re-ranking)해야 하기 때문입니다. 하지만 Spotify는 이를 위해 고도화된 인덱싱 기술과 저지연(Low-latency) 데이터 처리 아키텍처를 활용하여, 사용자가 필터를 바꿀 때 발생하는 연산 부하를 최소로 유지하면서도 즉각적인 피드백을 제공할 것으로 보입니다.
심층 분석: 필터 버블(Filter Bubble)과 추천의 딜레마#
여기서 우리는 한 가지 중요한 엔지니어링적 질문을 던져야 합니다. "사용자의 제어권 강화가 오히려 추천의 질을 떨어뜨리지는 않을 것인가?"입니다. 추천 시스템의 고전적인 난제 중 하나는 '탐색(Exploration)'과 '활용(Exploitation)'의 균형입니다. 새로운 음악을 발견하게 하는 탐색과, 사용자가 좋아할 만한 익숙한 음악을 제공하는 활용 사이의 트레이드오프(Trade-off)입니다.
사용자가 너무 강력한 필터를 적용하게 되면, 소위 '필터 버블(Filter Bubble)' 현상이 심화될 수 있습니다. 알고리즘이 사용자의 취향을 너무 좁은 범위로 가두어 버려, 음악적 지평을 넓혀주는 '발견의 즐거움'이 상실될 위험이 있다는 뜻입니다. 이는 마치 오픈소스 라이브러리를 사용할 때 의존성(Dependency)을 너무 좁게 설정하여 시스템의 유연성을 떨어뜨리는 것과 같습니다.
하지만 Spotify의 이번 행보는 이 문제를 '사용자의 의도적 선택'으로 해결하려 합니다. 기존에는 알고리즘이 사용자의 취향을 '추측'했다면, 이제는 사용자가 '명시적(Explicit)'으로 가이드를 주는 것입니다. Apple Music이 큐레이터 중심의 에디토리얼 방식을 강조하며 '전문가의 안목'을 내세우고, YouTube Music이 방대한 데이터 기반의 '맥락적 추천'에 집중한다면, Spotify는 '사용자 주도형 하이브록 추천(User-driven Hybrid Recommendation)'이라는 독자적인 영역을 구축하려 하고 있습니다.
여러분은 어떻게 생각하십니까? 알고리즘이 알아서 찾아주는 '운명적인 발견'을 선호하시나요, 아니면 내가 직접 필터를 조절하여 찾아내는 '정밀한 검색'을 선호하시나요? 여러분의 취향이 알고리즘을 어떻게 변화시킬지 궁금합니다.
실용 가이드: 새로운 필터를 스마트하게 활용하는 법#
이번 업데이트를 통해 더욱 쾌적한 음악 감상을 위한 체크리스트를 제안합니다.
- 단계적 필터 적용 (Gradual Filtering): 처음부터 너무 많은 필터를 적용하지 마세요. 먼저 장르나 분위기 같은 큰 단위의 필터부터 적용하여, 알고리즘의 추천 범위가 어떻게 변하는지 모니터링하는 것이 좋습니다.
- 필터 초기화 주기 설정: 특정 필터를 너무 오래 유지하면 추천 리스트가 고착화될 수 있습니다. 주기적으로 필터를 초기화하거나 범위를 넓혀서 '알고리즘의 편향(Bias)'을 방지하세요.
- 피드백 루프 활용: 필터를 적용한 상태에서 마음에 드는 곡에는 '좋아요'를, 그렇지 않은 곡에는 '스킵'을 명확히 하세요. 사용자의 필터 설정과 명시적 피드백이 결합될 때, Spotify의 모델은 더욱 강력한 개인화 성능을 발휘하게 됩니다.
필자의 한마디#
기술의 발전은 결국 인간에게 '통제권'을 돌려주는 방향으로 흐릅니다. 과거의 추천 시스템이 블랙박스(Black-box)처럼 작동했다면, 이제는 사용자가 그 내부 로직의 파라미터를 조정할 수 있는 인터페이스를 갖게 된 것입니다. 이는 개인화 기술의 성숙도를 보여주는 지표입니다.
앞으로 AI 모델이 더욱 정교해짐에 따라, 단순한 텍str 필터링을 넘어 사용자의 '기분'이나 '상황'을 자연어로 입력받아 처리하는 생성형 AI 기반의 큐레이션이 등장할 것으로 전망합니다. 실무 관점에서 결론은 명확합니다. 사용자의 피드백을 얼마나 정밀하게 데이터 파이프라인에 녹여내느냐가 향가 플랫폼의 승패를 가를 것입니다. 댓글로 여러분의 의견을 남겨주세요. 코드마스터였습니다.
출처: "https://9to5mac.com/2026/07/10/spotify-makes-release-radar-more-customizable-with-new-listening-filters/"
Sponsored Advertisement


💬 기술 토론 및 피드백 0
건전하고 유익한 토론을 지향합니다아직 등록된 의견이 없습니다.
이 아티클에 관한 궁금한 점이나 추가 팁을 첫 번째로 남겨보세요!
기술 토론에 참여하시려면 로그인해 주세요.
로그인 후 댓글 작성